

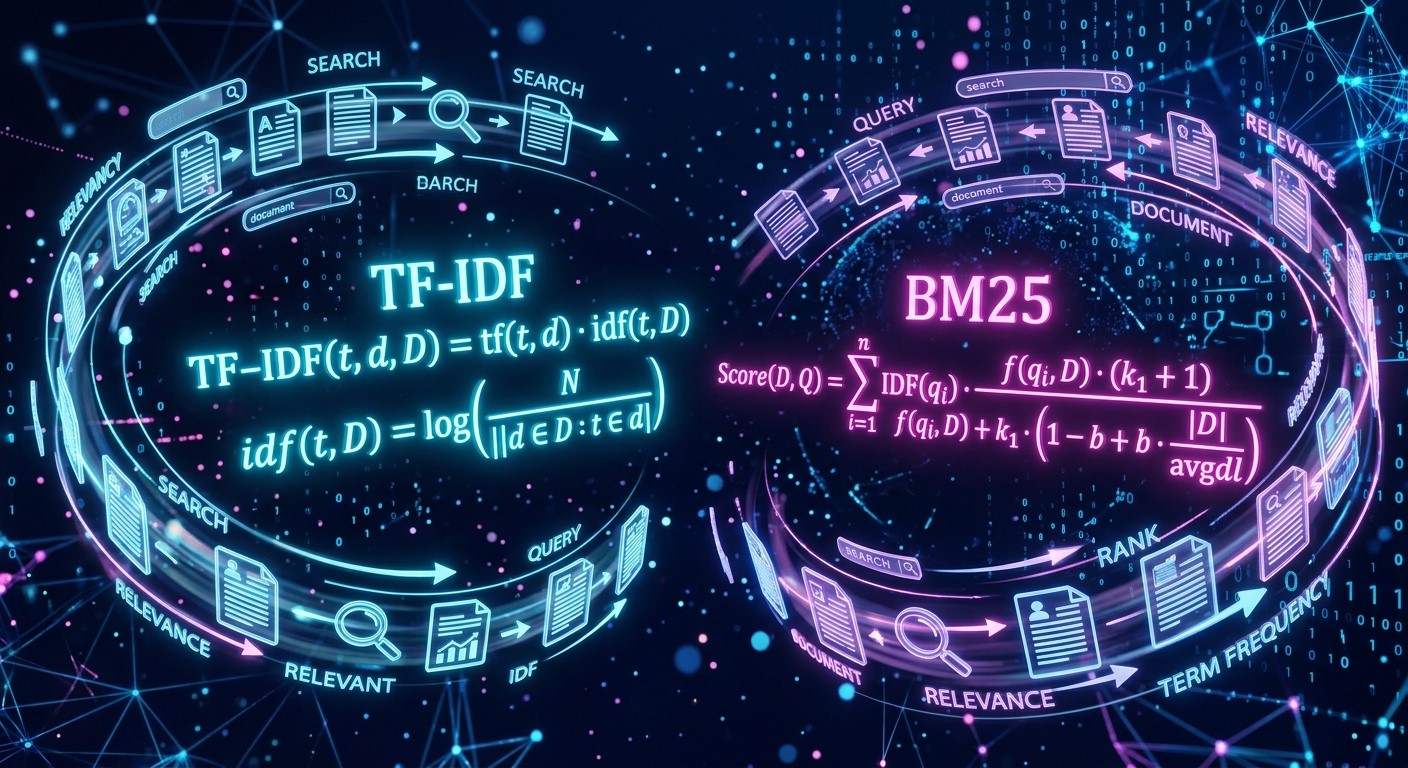
TF-IDF оценивает важность слова по его частоте в документе и редкости в корпусе, формируя базовый вес термина. Алгоритм BM25 развивает похожую идею, но добавляет насыщение частоты и нормализацию длины документа, что делает оценку более устойчивой. На практике бм25 часто подходит для полнотекстового поиска, однако окончательный выбор между TF-IDF и BM25 зависит от коллекции документов, длины полей и результатов тестирования.
Интернет-маркетолог-практик · в digital с 2016 года
Разбираю поисковые модели на практике: когда достаточно TF-IDF, а когда BM25 лучше контролирует длину документов и частоту терминов.
Как работает TF-IDF
TF-IDF — это классический способ оценки релевантности текста, основанный на статистике встречаемости слов. Расчёт строится в четыре последовательных этапа.
- Определяется частота термина в документе — сколько раз конкретное слово запроса встречается в тексте
- Рассчитывается редкость термина во всём корпусе — насколько часто это слово встречается в других документах коллекции
- Компоненты объединяются в итоговый вес термина для конкретного документа
- Документы сортируются по суммарной оценке всех совпавших терминов запроса
Формула выглядит так:
Расшифровка обозначений:
(TF(t,d)) — частота термина (t) в документе (d), то есть количество вхождений слова, часто нормированное относительно длины текста;
(IDF(t)) — обратная частота документа, показатель редкости термина во всей коллекции.
Редкие термины обычно получают больший вес, чем слова, встречающиеся почти во всех документах: если слово присутствует в большинстве текстов корпуса, оно слабо помогает отличить релевантный документ от нерелевантного.
Практический пример
Рассмотрим два условных документа для запроса с одним ключевым словом.
Короткая карточка товара, где слово встречается 2 раза в компактном описании.
Длинная статья на ту же тему, где слово встречается 15 раз просто из-за большего объёма текста.
Формально итоговый вес по TF-IDF у длинной статьи может оказаться выше только из-за суммарного количества слов, а не потому, что она лучше отвечает на запрос пользователя. Так проявляется ограничение классической модели: она может дать преимущество длинному документу, даже если он раскрывает тему хуже, чем компактная и точная страница.
TF-IDF хорошо объясняет базовую механику текстовой релевантности, но его классическая форма ограниченно учитывает длину документов и чрезмерные повторы терминов. Именно эти два ограничения впоследствии стали отправной точкой для разработки BM25 как более гибкой модели ранжирования.
Что такое алгоритм BM25 и как он рассчитывает релевантность
Алгоритм BM25 — это вероятностная модель ранжирования, которая оценивает совпадение терминов запроса с документом и корректирует результат с учётом частоты слов и длины документа. Название расшифровывается как Best Matching 25 — двадцать пятая по счёту версия формулы, разработанной в рамках исследований вероятностной модели релевантности.
Формула BM25:
Расшифровка каждого обозначения:
- (D) — документ, который оценивается на соответствие запросу
- (Q) — поисковый запрос пользователя
- (t) — конкретный термин запроса
- (f(t,D)) — количество вхождений термина (t) в документ (D)
- (|D|) — длина документа, обычно измеряемая в словах
- (avgdl) — средняя длина документа среди других документов из текстовой коллекции
- (k_1) — параметр насыщения частоты термина
- (b) — параметр нормализации длины документа
(IDF(t)) — вес редкости термина, отражающий его информативность в масштабе всей коллекции.
Порядок расчёта
Оценка BM25 для документа формируется последовательно:
- Определить, какие термины запроса встречаются в документе
- Рассчитать редкость каждого термина в корпусе через IDF
- Учесть фактическую частоту термина в конкретном документе
- Применить эффект насыщения, ограничивающий влияние повторов
- Скорректировать оценку с учётом длины документа относительно средней длины по коллекции
- Суммировать вклад всех совпавших терминов в итоговый score документа
Эффект насыщения
На практике BM25 ограничивает пользу повторения одного и того же термина за счёт эффекта насыщения. Каждое новое вхождение слова увеличивает оценку всё меньше, чем предыдущее. Это устроено так, что связь между частотой термина и релевантностью не должна быть линейной, она должна насыщаться: первые несколько вхождений термина — это сильный сигнал релевантности, а каждое следующее вхождение добавляет всё меньше, и в итоге дополнительные повторы почти ничего не дают. Такой механизм ограничивает ситуацию, при которой документ получает завышенный балл только за многократное повторение одного слова.
Алгоритм BM25 сохраняет идею TF-IDF о важности редких терминов, но добавляет более управляемую модель частоты и длины документа. Это делает бм25 более предсказуемым инструментом для сценариев, где документы сильно различаются по объёму текста.
BM25 и TF-IDF: ключевые различия
Обе модели относятся к лексическим, то есть работают с совпадением конкретных слов запроса и документа, а не со смыслом текста. Но механика расчёта у них заметно отличается.
| Критерий | TF-IDF | BM25 |
|---|---|---|
| Теоретическая основа | Взвешивание терминов | Вероятностное ранжирование |
| Частота термина | Может расти линейно или по выбранной нормализации | Использует эффект насыщения |
| Длина документа | В классической форме учитывается ограниченно | Учитывается через параметр (b) |
| Редкость термина | Использует IDF | Использует вероятностную форму IDF |
| Настройка | Обычно проще | Требует настройки (k_1), (b) и проверки на данных |
| Интерпретируемость | Высокая | Высокая, несмотря на более сложную формулу |
| Типичное применение | Базовый поиск, признаки, учебные модели | Полнотекстовый поиск и поисковые движки |
| Основной риск | Перевес длинных документов или повторов | Неудачная настройка под конкретную коллекцию |
| Работа с короткими полями | Может быть достаточной | Требует проверки нормализации длины |
| Семантика | Не понимает смысл напрямую | Также не понимает смысл напрямую |
Технически обе модели похожи по структуре: BM25 относится к вероятностным моделям, а TF-IDF — к векторной пространственной модели, но их формулы не так сильно отличаются, как может показаться; обе модели определяют вес каждого термина как произведение некоторой IDF-функции и TF-функции. Разница проявляется в деталях расчёта: обе модели признают, что для часто встречающихся терминов дальнейший рост частоты слабо влияет на релевантность, но BM25 идёт дальше — функция насыщения BM25 асимптотически приближается к пределу для высоких значений частоты термина, тогда как логарифм в TF-IDF границы не имеет.
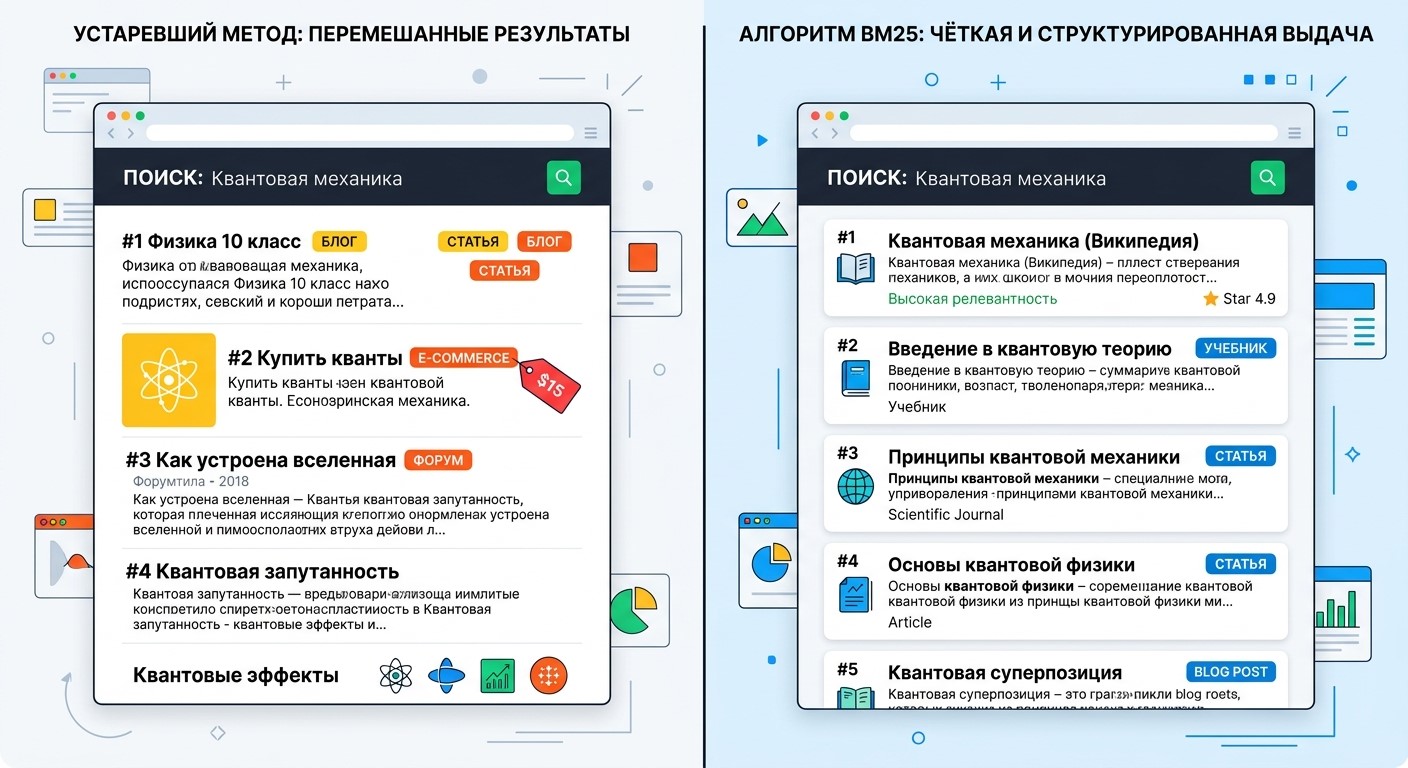
BM25 не является семантической или нейросетевой моделью. Он работает прежде всего с лексическим совпадением терминов запроса и документа, опираясь на статистику встречаемости слов, а не на понимание смысла текста.
BM25 обычно точнее контролирует влияние частоты и длины документа, однако TF-IDF остаётся полезным как простая, быстрая и прозрачная модель. Для учебных задач и понимания базовой механики текстовой релевантности этого часто достаточно.
Параметры (k_1) и (b): как они влияют на поиск
Параметр (k_1)
Параметр (k_1) регулирует скорость насыщения частоты термина. Он определяет, насколько быстро дополнительные вхождения слова перестают увеличивать оценку документа.
Низкое значение (k_1) быстрее ограничивает пользу повторов термина в тексте.
Высокое значение позволяет частоте термина сильнее влиять на итоговую оценку.
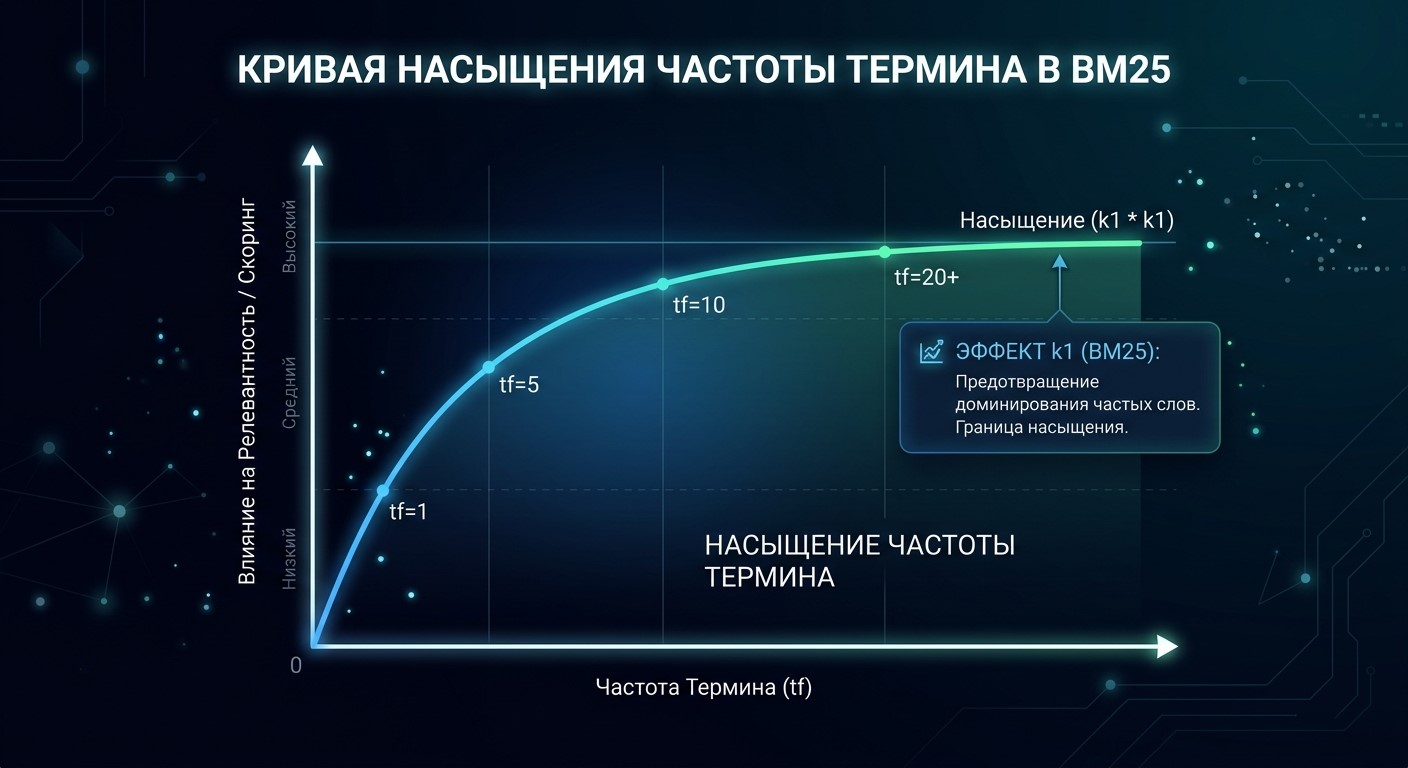
Значение около 1,2 часто используется как типичное стартовое значение, но не является универсально оптимальным для любой коллекции.
При (k_1=0) влияние частоты термина существенно ограничивается — модель почти перестаёт различать документы по количеству вхождений слова.
Некоторые источники также приводят иное типичное значение: без специальной оптимизации параметр k1 обычно выбирают в диапазоне от 1,2 до 2,0, а b принимают равным 0,75. Это подтверждает, что конкретное число зависит от реализации и коллекции.
Параметр (b)
Параметр (b) регулирует силу нормализации длины документа относительно средней длины по коллекции.
Значение около 0,75 часто используется как типичное стартовое значение.
Диапазон (b) — от 0 до 1.
При (b=0) влияние длины документа отсутствует, оценка не зависит от объёма текста.
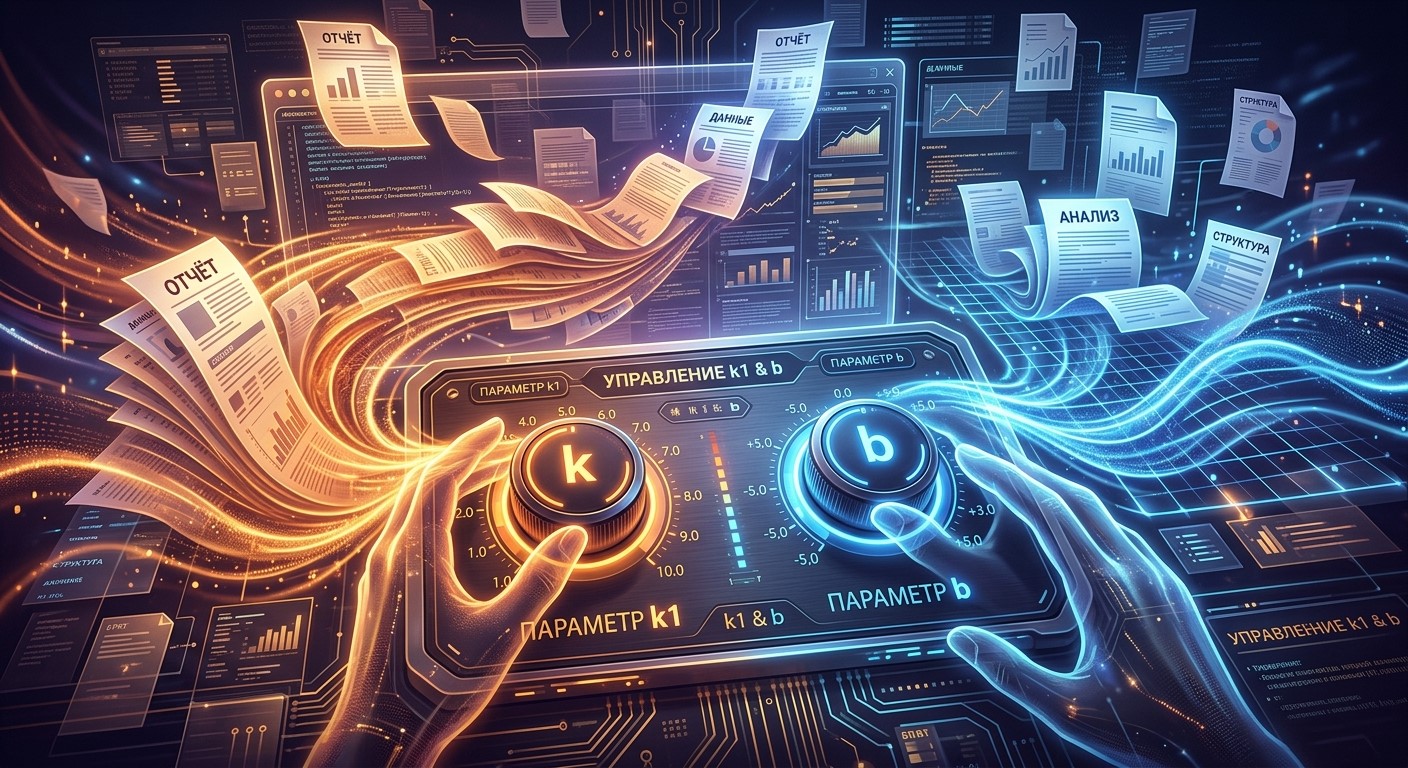
При (b=1) нормализация длины максимальна в рамках данной модели — при b = 1 применяется полная нормализация по длине: эффективная частота термина масштабируется пропорционально отношению длины документа к средней.
Крайние значения параметра нельзя считать универсально оптимальными для всех типов документов.
Параметр
Что регулирует
Практический эффект
(k_1)
Насыщение частоты термина
Ограничивает или усиливает пользу повторов
(b)
Нормализацию длины
Корректирует преимущество длинных и коротких документов
(avgdl)
Среднюю длину документа
Задаёт базу для сравнения длины
(IDF)
Редкость термина
Повышает вес редких слов
(k_1) и (b) нельзя настраивать изолированно от типа документов, длины полей и поисковых метрик. Стартовые значения подходят для экспериментов, но финальное решение по алгоритму BM25 нужно принимать по результатам тестирования на реальных запросах.
Мнение эксперта
По мнению Егорова Максима, при настройке поиска важно оценивать BM25 на реальных запросах и не отделять алгоритм ранжирования от качества индексации и структуры данных.
Практический пример расчёта релевантности
Рассмотрим иллюстративный сценарий с поисковым запросом «контекстная реклама». Условно сравним три документа одного сайта.
Короткая страница услуги. Фраза «контекстная реклама» встречается 3 раза, есть упоминания «Яндекс Директ», «ставки», «объявления». Текст компактный, тема раскрыта по существу.
Подробная статья. Фраза встречается 10 раз в развёрнутом материале про настройку рекламы, ключевые слова и ставки, объём текста значительно больше средней длины документа в коллекции.
Страница, где фраза повторяется слишком часто. Условно 40 повторений словосочетания в тексте среднего объёма, что выглядит как искусственная переоптимизация.
Все числа в этом примере условные и используются только для иллюстрации механики расчёта, а не как результат реального теста.
Что происходит при расчёте по алгоритму BM25:
Редкий термин получает более высокий вес IDF, если он нечасто встречается в остальной части коллекции.
Повторение термина повышает оценку документа только до определённого предела за счёт насыщения частоты.
Слишком длинный документ (как во втором примере) может получить корректировку через параметр (b), если его объём значительно превышает (avgdl).
Алгоритм bm25 не оценивает качество текста полностью — он видит статистику слов, а не смысл и пользу материала для читателя.
BM25 не проверяет достоверность, стиль, коммерческую ценность и удобство страницы услуги — это остаётся задачей редактора и маркетолога.
Третий документ с чрезмерным повторением фразы не получит пропорционально большую оценку по сравнению с первым — эффект насыщения ограничит рост score после нескольких вхождений термина.
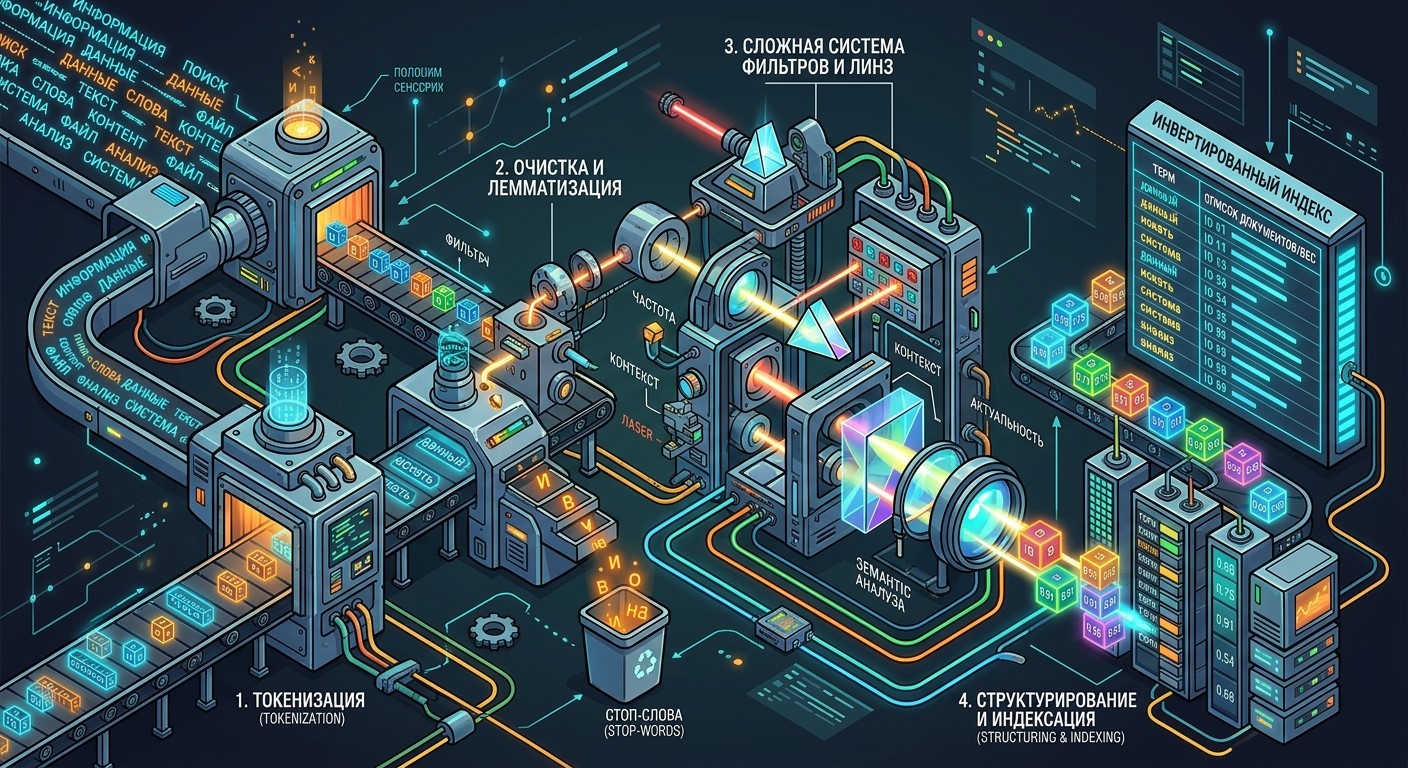
Практический расчёт помогает понять механику BM25, но итоговая релевантность зависит от токенизации, морфологии, стоп-слов, полей документа и настроек поисковой системы. Именно поэтому бм25 в реальных системах редко работает «в чистом виде» — вокруг него выстраивается слой дополнительной обработки текста.
Когда выбрать TF-IDF, а когда BM25
Ситуация
Предпочтительный вариант
Обоснование
Учебный проект
TF-IDF
Простая формула и прозрачная логика
Быстрый прототип
TF-IDF или BM25
Выбор зависит от библиотеки и требований
Полнотекстовый поиск по статьям
BM25
Лучше контролирует длину и частоту терминов
Каталог товаров
BM25 с настройкой полей
Важны название, характеристики и описание
Короткие названия
Проверить нормализацию длины
Штраф за длину может быть неуместен
Поиск по юридическим или техническим документам
BM25 + тестовый набор
Документы часто существенно отличаются по длине
Семантический поиск
Гибрид BM25 и векторной модели
Одного лексического совпадения недостаточно
Маленький корпус
Оба варианта после проверки
IDF может быть нестабильным на малом объёме данных
Критерии, которые стоит учитывать при выборе между TF-IDF и BM25:
- размер корпуса документов
- средняя и медианная длина документов
- длина типичных поисковых запросов
- наличие морфологии и синонимов в текстах
- количество коротких и длинных полей у документа
- требования к скорости расчёта релевантности
- качество разметки релевантных результатов для оценки
- необходимость гибридного поиска, сочетающего лексику и смысл
возможность проведения A/B-тестирования разных настроек.
Для простых и учебных задач часто достаточно TF-IDF. Для полноценного лексического поиска обычно целесообразно начать с BM25, а затем проверить его на реальных запросах и документах, прежде чем закреплять итоговые параметры алгоритма BM25 в продакшене.
Ограничения BM25 и типичные ошибки внедрения
Несмотря на широкое применение, у алгоритма BM25 есть существенные ограничения:
- BM25 не понимает смысл слова так, как это делает нейросетевая модель — он оперирует статистикой совпадений, а не значением текста
- BM25 может не учитывать синонимы без дополнительной обработки запроса или расширения индекса
- BM25 чувствителен к токенизации и морфологическому анализу — без правильной обработки словоформ часть релевантных документов может быть пропущена
- BM25 не заменяет бизнес-правила ранжирования, например приоритет свежих товаров или наличие на складе
- BM25 не оценивает достоверность и качество текста как таковые
- BM25 не гарантирует одинаковое качество работы на разных коллекциях документов
BM25 может работать некорректно при неправильной настройке полей документа, если, например, заголовок и полное описание смешаны в одном текстовом поле.
Типичные ошибки при внедрении:
- использование параметров (k_1) и (b) по умолчанию без проверки на собственных данных
- смешение заголовка, описания и технических характеристик в одно поле индекса
- отсутствие тестового набора реальных поисковых запросов
- оценка качества поиска только по одному-двум примерам запросов
- отсутствие анализа нулевых результатов поиска
- игнорирование синонимов, опечаток и словоформ при подготовке текста
- сравнение алгоритмов ранжирования без одинаковой токенизации и предобработки
выводы о качестве по одному показателю без учёта пользовательских метрик поведения.
Алгоритм BM25 — сильная базовая модель лексического поиска, но её реальное качество зависит от подготовки данных, настройки полей документа и корректной методики оценки результатов.
Как тестировать качество поиска на практике
Проверка релевантности требует системного подхода, а не разовой проверки на одном запросе.
Сформировать набор реальных поисковых запросов пользователей.
Разделить запросы на информационные, товарные, навигационные и технические.
Для каждого запроса определить заведомо релевантные документы вручную или с помощью асессоров.
Запустить поиск на TF-IDF и на BM25 в одинаковых условиях.
- Сравнить результаты при идентичной токенизации и обработке текста
- Проверить метрики Precision@k, Recall@k, MRR или NDCG
Отдельно проанализировать поведение алгоритма на коротких и длинных документах.
- Проверить влияние изменения параметров (k_1) и (b) на итоговый порядок выдачи
- Зафиксировать финальные настройки и повторить тестирование после любых изменений индекса или полей
Ключевые метрики оценки качества поиска:
Precision@k — доля релевантных документов среди первых k результатов выдачи; показывает, насколько «чистой» получается верхняя часть списка.
Recall@k — доля всех релевантных документов коллекции, которые попали в первые k результатов; отражает полноту покрытия релевантных материалов.
MRR (Mean Reciprocal Rank) — средняя обратная позиция первого релевантного документа по набору запросов; полезна, когда важен именно первый правильный ответ.
NDCG (Normalized Discounted Cumulative Gain) — метрика, учитывающая не только наличие релевантных документов, но и их порядок с учётом убывающей значимости позиций.
Если приводится конкретное число, важно указывать контекст: размер тестовой выборки запросов, период их сбора, тип корпуса документов, используемую метрику, базовую модель для сравнения и параметры теста. Без такого контекста цифры остаются условными и не подлежат обобщению на другие проекты.
Анализ релевантности по метрикам помогает находить не только проблемы в самом алгоритме, но и пробелы в структуре страниц, полноте терминов и распределении контента по разделам сайта. Комплексная работа с поисковой видимостью, например услуга «SEO продвижение», часто включает такой анализ как один из этапов диагностики. Отдельно стоит учитывать направление «Продвижение в Нейросетях» — это работа с присутствием бренда в ответах ИИ-систем, которая строится на других принципах и не сводится к классическому BM25.
Корректный выбор между TF-IDF и BM25 определяется не популярностью алгоритма, а результатами тестирования на собственных запросах, документах и задачах поиска. Именно бм25 чаще становится стартовой точкой для полнотекстового поиска, но финальное решение всегда должно опираться на данные конкретного проекта.
Роль BM25 в современных поисковых системах
Алгоритм BM25 используется в разных сценариях лексического поиска:
- как базовый механизм полнотекстового поиска по контенту сайта
- как компонент более сложного пайплайна ранжирования вместе с бизнес-правилами
- как часть гибридного поиска, объединяющего лексические и векторные сигналы
- как источник признаков, которые впоследствии смешиваются с результатами семантических моделей
для поиска по товарам, справочным материалам, документации и внутренним базам знаний компаний.
В некоторых поисковых движках и библиотеках BM25 используется как алгоритм релевантности по умолчанию. Например, начиная с версии Elasticsearch 5.0, алгоритм BM25 стал модулем оценки схожести по умолчанию. При этом конкретная реализация может заметно отличаться в разных системах из-за:
- используемых текстовых анализаторов и правил токенизации
- способов подсчёта IDF и сглаживающих констант в формуле
- набора полей документа, участвующих в поиске
- дополнительных фильтров и стоп-слов
дополнительных правил ранжирования поверх базового score.
Важно разделять смежные, но разные понятия:
- BM25 — лексическая модель, оценивающая совпадение терминов запроса и документа
- векторный поиск — поиск по числовому представлению смысла текста, где документ и запрос превращаются в вектор в многомерном пространстве
- гибридный поиск — подход, объединяющий лексический сигнал от BM25 и векторный сигнал от смысловой модели в единую оценку
ранжирование — итоговая сортировка найденных документов по агрегированной оценке, которая может включать не только текстовую релевантность, но и другие сигналы.
Алгоритм BM25 остаётся важной базовой моделью текстового поиска, но для сложных запросов его часто комбинируют с синонимами, морфологией, бизнес-правилами и векторными методами. Такое сочетание позволяет закрыть слабые места чисто лексического подхода без отказа от его прозрачности и предсказуемости.
Цифры и факты
Формула BM25: (Score(D,Q)=\sum_{t \in Q} IDF(t) \cdot \frac{f(t,D)(k_1+1)}{f(t,D)+k_1\left(1-b+b\frac{|D|}{avgdl}\right)}).
(k_1 \approx 1{,}2) — типичное стартовое значение параметра насыщения частоты термина (пример, не универсальная константа).
(b \approx 0{,}75) — типичное стартовое значение параметра нормализации длины документа (пример).
Диапазон параметра (b): (0 \leq b \leq 1).
При (k_1=0) влияние частоты термина существенно ограничивается — модель почти не различает документы по количеству повторов слова.
(avgdl) — средняя длина документа в корпусе, база для сравнения длины конкретного документа при нормализации.
Иллюстративный сценарий тестирования включает минимум 3 условных документа: короткую страницу услуги, подробную статью и страницу с избыточным повторением фразы.
Метрики оценки качества поиска: Precision@k, Recall@k, MRR (можно дополнительно использовать NDCG).
Критерии выбора алгоритма: размер корпуса, средняя длина документов, длина запросов, наличие морфологии и синонимов, требования к скорости расчёта, качество разметки релевантности.
Что важно знать
BM25 и TF-IDF относятся к лексическим моделям релевантности, работающим с совпадением терминов.
BM25 учитывает совпадение терминов, их редкость и длину документа в единой формуле.
Частое повторение слова не даёт бесконечного роста оценки благодаря эффекту насыщения.
Параметр (k_1) регулирует насыщение частоты термина в документе.
Параметр (b) регулирует влияние длины документа на итоговую оценку.
TF-IDF проще для объяснения, реализации и первичного прототипирования.
BM25 обычно удобнее как базовый алгоритм полнотекстового поиска в реальных проектах.
Финальный выбор между TF-IDF и BM25 делают по тестам на реальных запросах и документах, а не по репутации алгоритма.
Для смыслового поиска, где важно учитывать не только слова, но и контекст запроса, BM25 может дополняться векторной моделью в рамках гибридного поиска.
Если нужен практический разбор поисковой видимости и продвижения сайта, можно обратиться к частному рекламщику за консультацией.
Интернет-маркетолог-практик · в digital с 2016 года
Разбираю поисковые модели на практике: когда достаточно TF-IDF, а когда BM25 лучше контролирует длину документов и частоту терминов.
Нужен разбор релевантности под ваш поиск?
Поможем выбрать и протестировать модель ранжирования под вашу коллекцию документов и сценарии поиска.
Обсудить задачу